


Divulgação: este artigo contém links de afiliados. Se você assinar através deles, podemos receber uma comissão sem nenhum custo adicional para você.
Você quer superar a concorrência? Então um conhecimento básico de SEO técnico é obrigatório. Claro que você também precisa criar conteúdo relevante e de qualidade. Ainda assim, é bom entender um dos conceitos mais importantes do SEO técnico: a rastreabilidade (crawlability).
Resposta rápida: o que é rastreabilidade?
Rastreabilidade é a capacidade que o Google tem de percorrer e ler as páginas do seu site. Se algo bloqueia o rastreador — uma regra no robots.txt, um código de status HTTP de erro ou uma meta tag robots —, a página não entra no índice e simplesmente não aparece nos resultados de busca. Sem rastreabilidade, nada de SEO.
O que é o rastreador, mesmo?
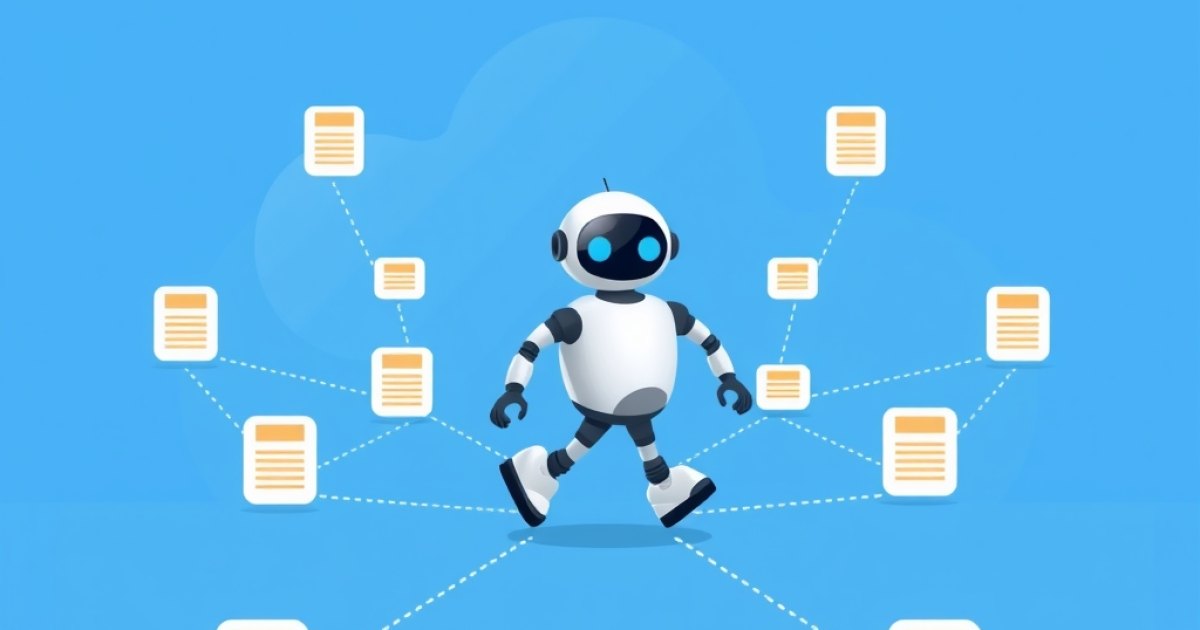
Um buscador como o Google é formado por três coisas: um rastreador, um índice e um algoritmo. O rastreador segue os links da web. E faz isso 24 horas por dia, 7 dias por semana! Assim que chega a um site, ele salva a versão HTML em um banco de dados gigantesco chamado índice. Esse índice é atualizado toda vez que o rastreador passa pelo seu site e encontra uma versão nova ou revisada. Dependendo de quão importante o Google considera o seu site e da quantidade de mudanças que você faz, o rastreador aparece com mais ou menos frequência.
Curiosidade: o rastreador também é chamado de robô, bot ou aranha (spider). E o rastreador do Google é conhecido como Googlebot.
E o que é rastreabilidade?
A rastreabilidade tem a ver com as possibilidades que o Google tem de rastrear o seu site. E, felizmente, você pode bloquear rastreadores. Se o seu site ou uma página dele está bloqueada, você está dizendo ao rastreador do Google: “não venha aqui”. Como resultado, o site ou aquela página não aparece nos resultados de busca. Pelo menos, na maioria dos casos.
Então, como se bloqueia um rastreador? Há algumas coisas que podem impedir o Google de rastrear (ou indexar) o seu site:
- Se o seu arquivo robots.txt bloqueia o rastreador, o Google não vem ao seu site nem àquela página específica.
- Antes de rastrear, o robô olha o cabeçalho HTTP da sua página. Esse cabeçalho contém um código de status. Se o código diz que a página não existe, o Google não rastreia.
- Se a meta tag robots de uma página específica impede o buscador de indexá-la, o Google até rastreia aquela página, mas não a adiciona ao índice.
Vale um alerta prático: a causa mais comum de um site sumir do Google não é penalidade, é bloqueio acidental. Uma auditoria técnica com a Semrush resolve essa dúvida rápido: ela rastreia o site inteiro como o Googlebot faria e lista exatamente quais URLs estão bloqueadas por robots.txt, marcadas como noindex, devolvendo erro de status ou órfãs sem nenhum link interno apontando para elas.
Como os rastreadores impactam o meio ambiente
Isso mesmo que você leu. Rastreadores têm um impacto ambiental considerável. Veja como: eles podem visitar o seu site várias vezes por dia. Por quê? Querem descobrir conteúdo novo ou checar se houve atualizações. E, toda vez que visitam, rastreiam tudo o que parece uma URL para eles. Ou seja, uma mesma URL costuma ser rastreada várias vezes ao dia.
Isso é desnecessário, porque dificilmente você faz várias alterações na mesma URL no mesmo dia. Sem contar que praticamente todo CMS gera URLs sem sentido, que os rastreadores poderiam pular com segurança. Mas, em vez de pular, eles rastreiam essas URLs de novo e de novo, toda vez que esbarram nelas. Todo esse rastreamento desnecessário consome muita energia, o que é prejudicial ao planeta.
Melhorando a rastreabilidade do seu site
Para não desperdiçar energia, é importante manter as configurações de rastreamento do seu site em dia. Felizmente, você não precisa fazer tudo na mão.
Plugins de SEO como o Yoast SEO Premium têm um recurso de configurações de rastreamento que remove URLs, feeds e recursos desnecessários do seu site. Isso faz com que os rastreadores percorram o site de forma mais eficiente. E você continua no controle: o recurso permite decidir, por tipo de recurso, se quer ou não remover aquela URL.
Quer aprender mais sobre rastreabilidade?
Embora a rastreabilidade seja uma parte básica do SEO técnico (ela tem a ver com tudo o que permite ao Google indexar o seu site), já é assunto bastante avançado para a maioria das pessoas. Ainda assim, é importante que você entenda o que ela é. Você pode estar bloqueando os rastreadores do seu site — talvez até sem saber! —, o que significa que nunca vai ranquear bem no Google. Então, se você leva o SEO a sério, a rastreabilidade deveria importar para você.
Perguntas frequentes
Qual a diferença entre rastreabilidade e indexabilidade?
Rastreabilidade é a capacidade do Google de acessar e ler a sua página. Indexabilidade é a permissão de guardá-la no índice. Uma página pode ser rastreável e, ainda assim, não indexável — é o caso de quem usa a meta tag noindex.
Como saber se o Google consegue rastrear o meu site?
Use a ferramenta de inspeção de URL do Google Search Console: ela mostra se a página foi rastreada, quando, e se houve algum bloqueio. Para uma visão do site inteiro, use uma ferramenta de auditoria que simule o rastreamento.
Bloquear páginas no robots.txt tira elas do Google?
Não necessariamente. O robots.txt impede o rastreamento, mas a URL ainda pode aparecer nos resultados se houver links externos apontando para ela. Para realmente remover do índice, use a meta tag noindex — e deixe a página rastreável, para que o Google consiga ler essa instrução.
O que é orçamento de rastreamento (crawl budget)?
É a quantidade de páginas que o Google se dispõe a rastrear no seu site em determinado período. Sites pequenos raramente precisam se preocupar; sites grandes, com milhares de URLs, ganham muito ao eliminar páginas inúteis do caminho do rastreador.